
 中国站


生成式AI托管服务 / 客户案例-龙腾出行
客户背景概述
“龙腾出行”是一个全球化的智能出行服务平台,专注于机场与高铁站商圈消费,通过智能场景服务与移动互联网技术全面提升用户的出行体验。平台自 2005 年起运营,业务覆盖 130 多个国家,为 4,000 多万会员提供全球 1,400 多间机场贵宾室、650 多个餐饮点,以及快速安检、接送等出行服务。
在核心业务系统迁移至 AWS 并由首都在线托管的基础上,龙腾出行在 AWS 上构建了面向会员的生成式 AI 问答能力,并已融入其主要移动应用:会员可以直接询问所持权益在当前机场能否使用、有哪些服务可选。首都在线作为其 AWS 托管服务合作伙伴,负责该工作负载的架构设计与 7×24 托管运维。
业务挑战
- 会员全球流动,服务需要就近:会员主要来自欧洲,却在全球 130 多个国家的机场使用权益。前端应用需要在欧洲与亚太就近部署,才能保证旅途中的访问速度。
- AI 与数据需要集中治理:权益条款、模型与内容安全策略若随前端分散到各地区,将面临版本不一致与治理困难;会员数据受欧盟 GDPR 等跨境数据监管约束,数据驻留边界必须在架构层面明确。
- 权益只有被用掉才算数:服务从贵宾室扩展到餐饮、快速安检与接送,卡种、机场、航站楼与同行人规则的组合愈发复杂,会员常常不知道自己能用什么。人工客服难以在各个时区、各个语种全天候覆盖。
- AI 工作负载运维复杂:负载横跨多个 AWS 账号与五个地区,包含 Kubernetes 集群、常驻 GPU 实例、自建向量数据库与托管模型服务,任一环节异常都会直接影响会员端的答复质量,需要 7×24 主动监控与响应。
- 成本与内容安全必须可控:模型按调用量计费、GPU 实例常驻运行,需要可计量、可限额;面向会员的答复须限定在权益范围内、妥善处理敏感信息,并保留可审计的调用记录。
建议架构概览
基于 AWS 提供的技术支持和最佳实践原则,架构的核心取舍是:前端按地区就近部署,AI 能力与会员数据集中在欧洲。
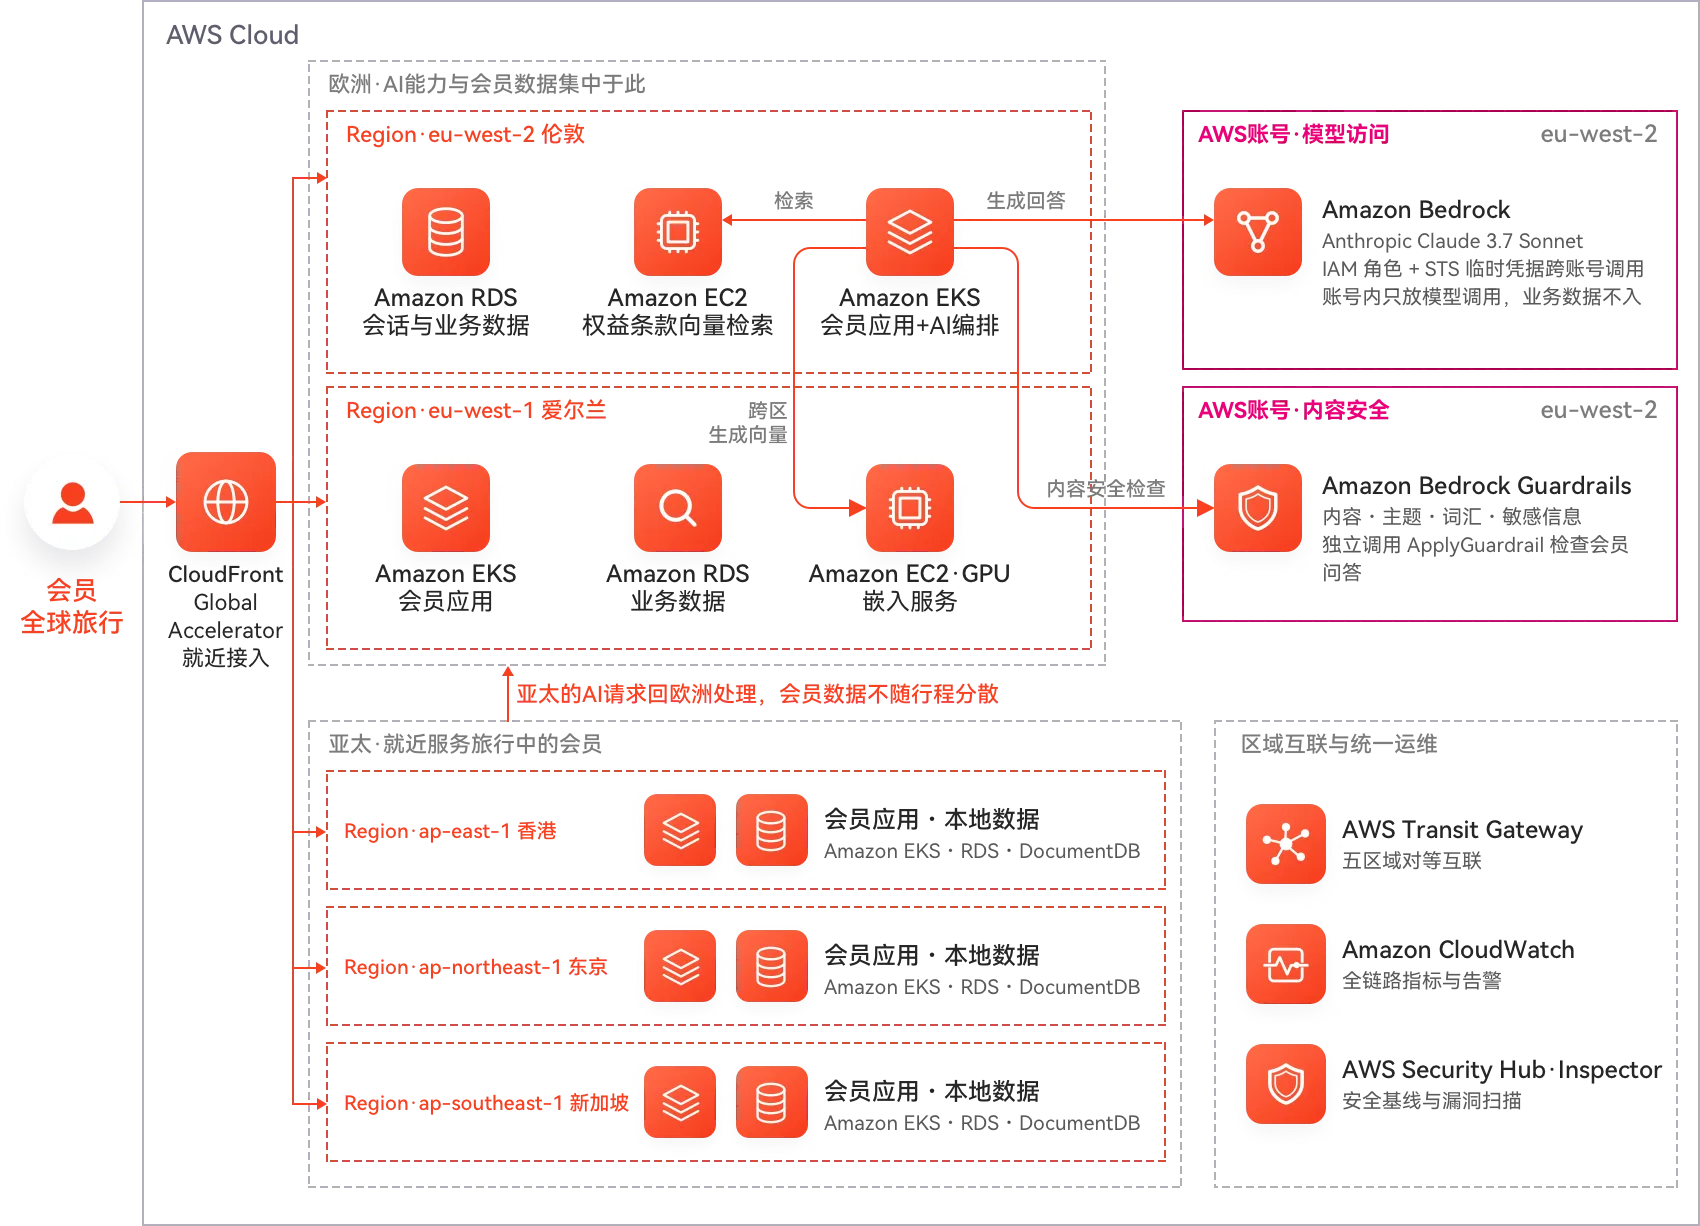
- 就近服务:欧洲两个地区与亚太三个地区(香港、东京、新加坡)各自部署完整的应用与数据层,经 Amazon CloudFront 与 AWS Global Accelerator 就近接入,各地区之间经 AWS Transit Gateway 互联。
- AI 集中在欧洲:AI 编排、向量检索与模型调用位于伦敦,常驻 GPU 嵌入服务位于爱尔兰。亚太地区的 AI 请求回到欧洲处理,知识库只维护一份,条款更新一次即全局生效。
- 模型访问隔离:Amazon Bedrock 模型调用放在独立的 AWS 账号中,应用通过跨账号 IAM 角色与临时凭据访问,不使用长期访问密钥;模型用量可独立计量、限额与审计,业务数据不进入该账号。
- 内容安全统一治理:会员问答经 Amazon Bedrock Guardrails 检查(内容、主题、词汇与敏感信息四类策略);护栏部署在另一独立账号,与模型同处伦敦,一套策略约束所有地区的 AI 请求。
项目成果
本项目完成后,实现以下关键成果:
- AI 融入主应用并持续稳定运行:生成式 AI 问答已作为主要移动应用的一部分对会员开放,每日不间断服务,覆盖全部五个部署地区的会员访问。
- 知识集中维护,变更即时生效:权益条款只在欧洲维护一份,所有地区的会员请求共用;贵宾室开放时间、服务范围等信息更新一次即全局生效,无需在各地区分别同步。
- 数据驻留边界清晰:会员数据与 AI 处理集中在欧洲地区,不因会员在境外使用而分散到其他司法辖区。
- 模型访问受控、可审计:模型调用隔离于独立账号,经临时凭据访问,用量可独立计量与限额;内容安全策略集中配置,统一约束所有地区的 AI 请求。
龙腾出行
所属行业: 智能出行服务
业务范围: 全球化的智能出行服务平台,专注于机场与高铁站商圈消费,通过智能场景服务与移动互联网技术全面提升用户的出行体验。
 返回 生成式 AI 托管服务

 关注首云
版权所有 ©2005 - 2025
Capitalonline Data Service Co., Ltd

北京首都在线科技股份有限公司(总部)
经营许可证:A2.B1-20140358