中国站


生成式 AI 托管服务
作为AWS的高级合作伙伴,我们帮助企业把生成式AI从概念验证带入生产环境:基于 Amazon Bedrock 设计检索增强生成(RAG)等生产级架构,内建账号隔离、数据驻留与内容安全控制,并在上线后提供7×24全链路托管运维。服务特色:落得了地、管得住、跑得稳。
服务优势

生产级交付
- 不止演示原型,交付可上线、可扩展的生产级架构
- 以准确率、延迟与成本三项指标评估上线条件
- 上线前完成压力测试与异常场景验证

安全合规内建
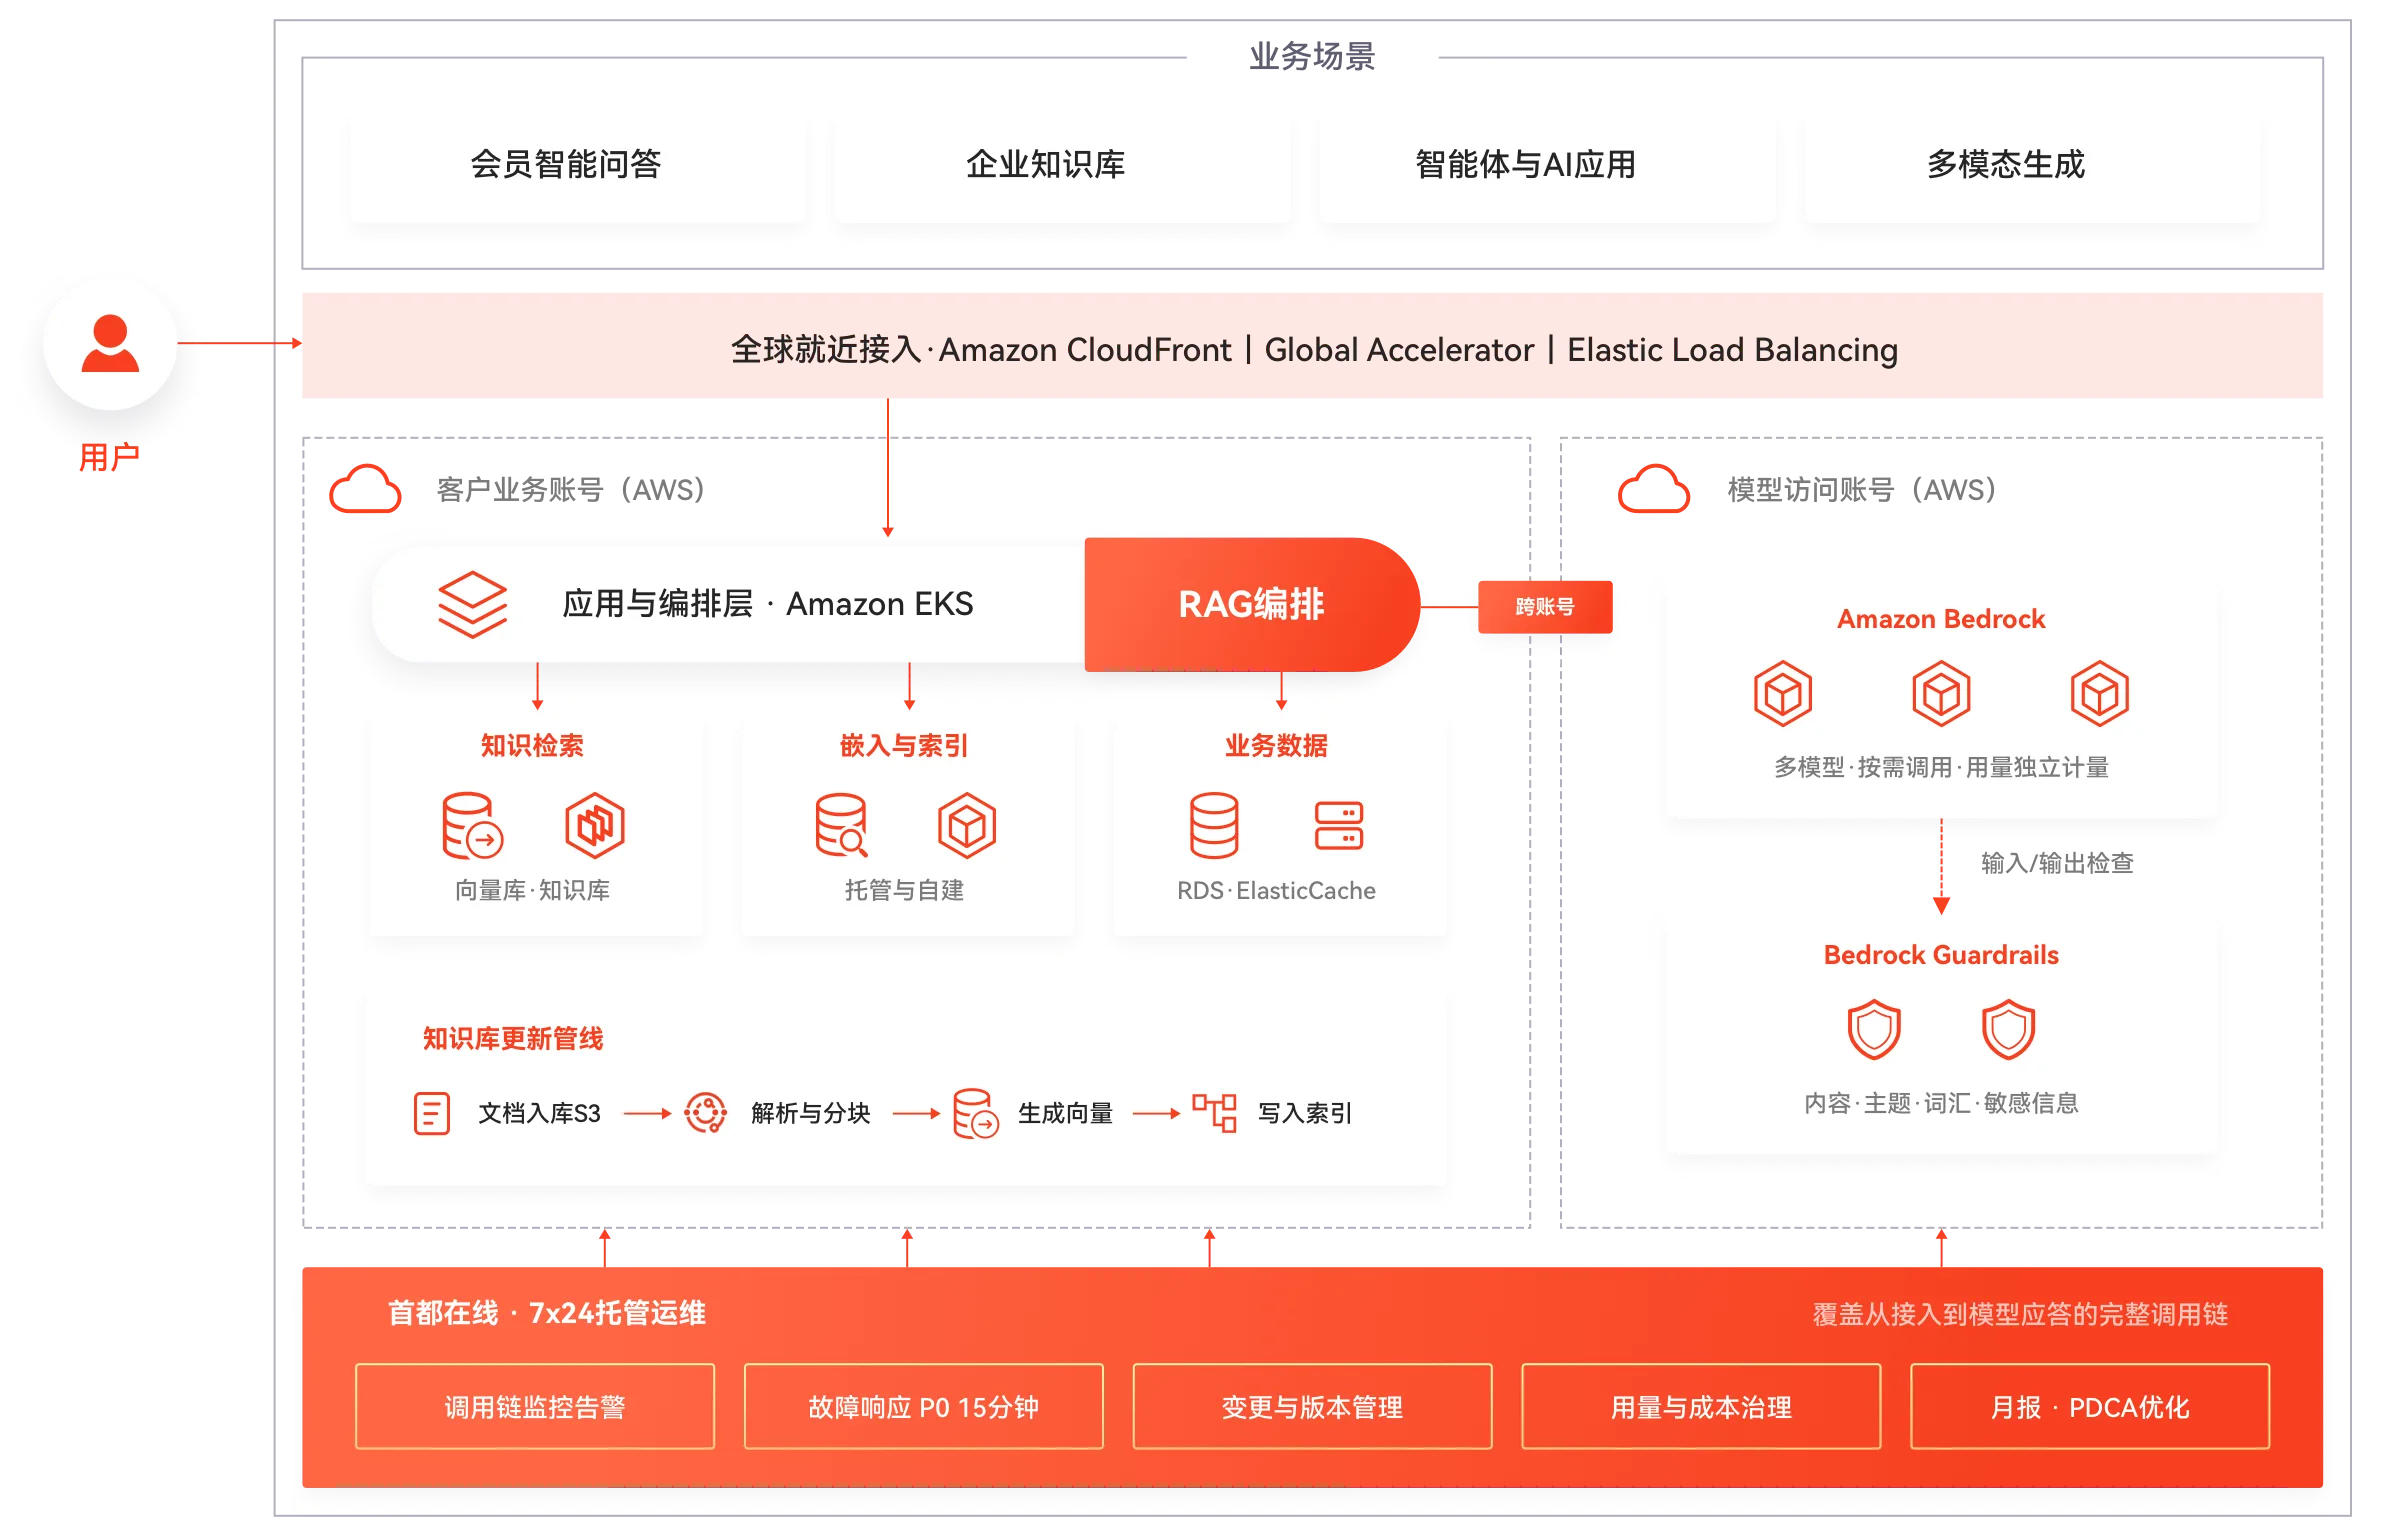
- 模型访问独立账号隔离,业务数据不出边界
- 按地域划定数据驻留边界,满足跨境合规要求
- 默认部署 Amazon Bedrock Guardrails,调用全程留痕

全链路托管运维
- 7×24 小时值守,覆盖从请求到应答的完整调用链
- 专属固定运维工程师,熟悉您的 AI 应用架构
- 遵循 ITIL 标准,系统已通过等保 2.0 认证
核心服务目录

生成式AI评估与规划
梳理业务场景与数据资产,判断哪些问题适合用生成式 AI 解决,明确合规边界与投入产出。交付:场景评估报告、数据源盘点清单、实施路线图。

架构设计与实施
基于 Amazon Bedrock 设计并落地检索增强生成(RAG)架构,完成账号、网络与多区域部署。交付:架构设计文档、Landing Zone 方案、部署手册。

模型选型与内容安全
在真实数据上评估多个基础模型的效果与成本,配置内容安全策略与调用审计。交付:模型评估报告、Guardrails 策略配置、审计日志方案。

AI 应用托管运维
上线后提供全链路监控、故障响应、版本与变更管理,以及知识库的持续更新。交付:运维手册、监控告警配置、月度服务报告。

用量与成本治理
让按调用量计费的模型与常驻的 GPU 算力都变得可计量、可限额、可优化。交付:用量计量方案、配额策略、成本优化报告。
作为值得信赖的生成式 AI 落地伙伴,我们以 AWS 托管服务的运维体系承接 AI 应用,
让企业专注于业务场景本身,把模型、数据与安全交给专业团队。
 模型接入
Amazon Bedrock | 多模型评估 | 提示词工程 | 跨账号访问
 知识检索
知识库构建 | 文档解析 | 向量检索 | 增量更新
 应用托管
容器化部署 | 弹性伸缩 | 多环境隔离 | 版本发布
 架构优化
多区域部署 | 就近接入 | 缓存优化 | 性能调优
 拓客与资源整合
内容安全护栏 | 数据驻留 | 权限最小化 | 调用审计
应用场景
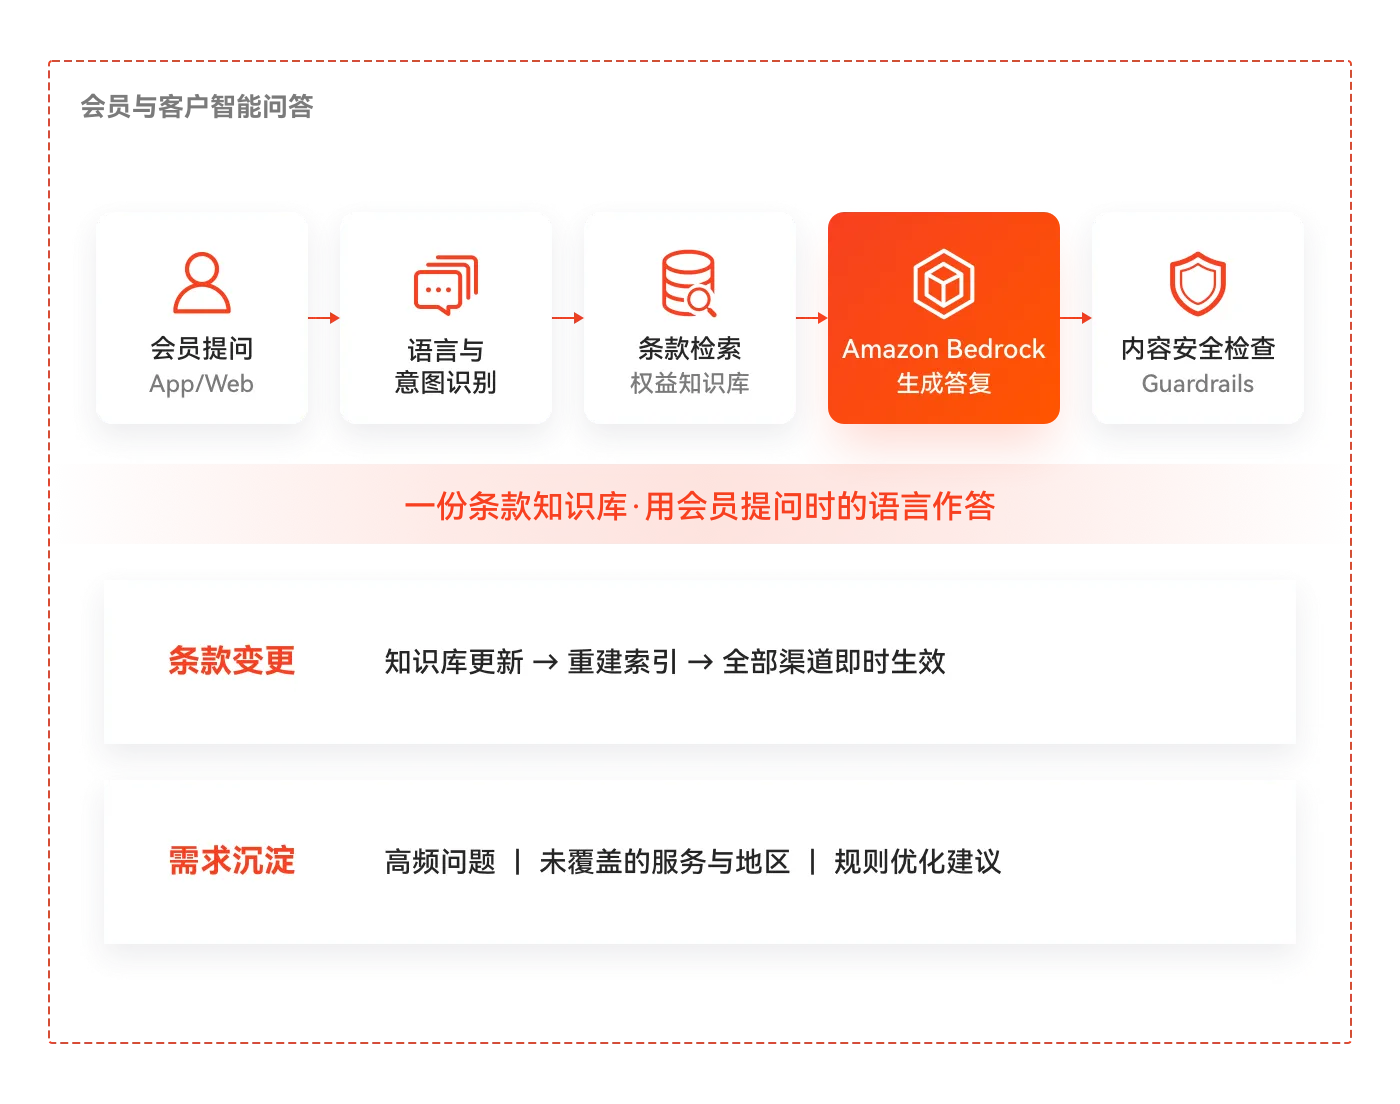
会员与客户智能问答
把复杂的权益、服务条款与产品规则,变成客户用自己的话就能问清楚的对话。答案以条款原文为依据,一份知识库即可用多种语言作答,条款变更一次更新、全部渠道即时生效。
客户收益
 多语言统一应答,新增市场无需重建内容。
条款更新即时生效,全部渠道答复口径一致。
客户提问沉淀为可分析的需求数据。
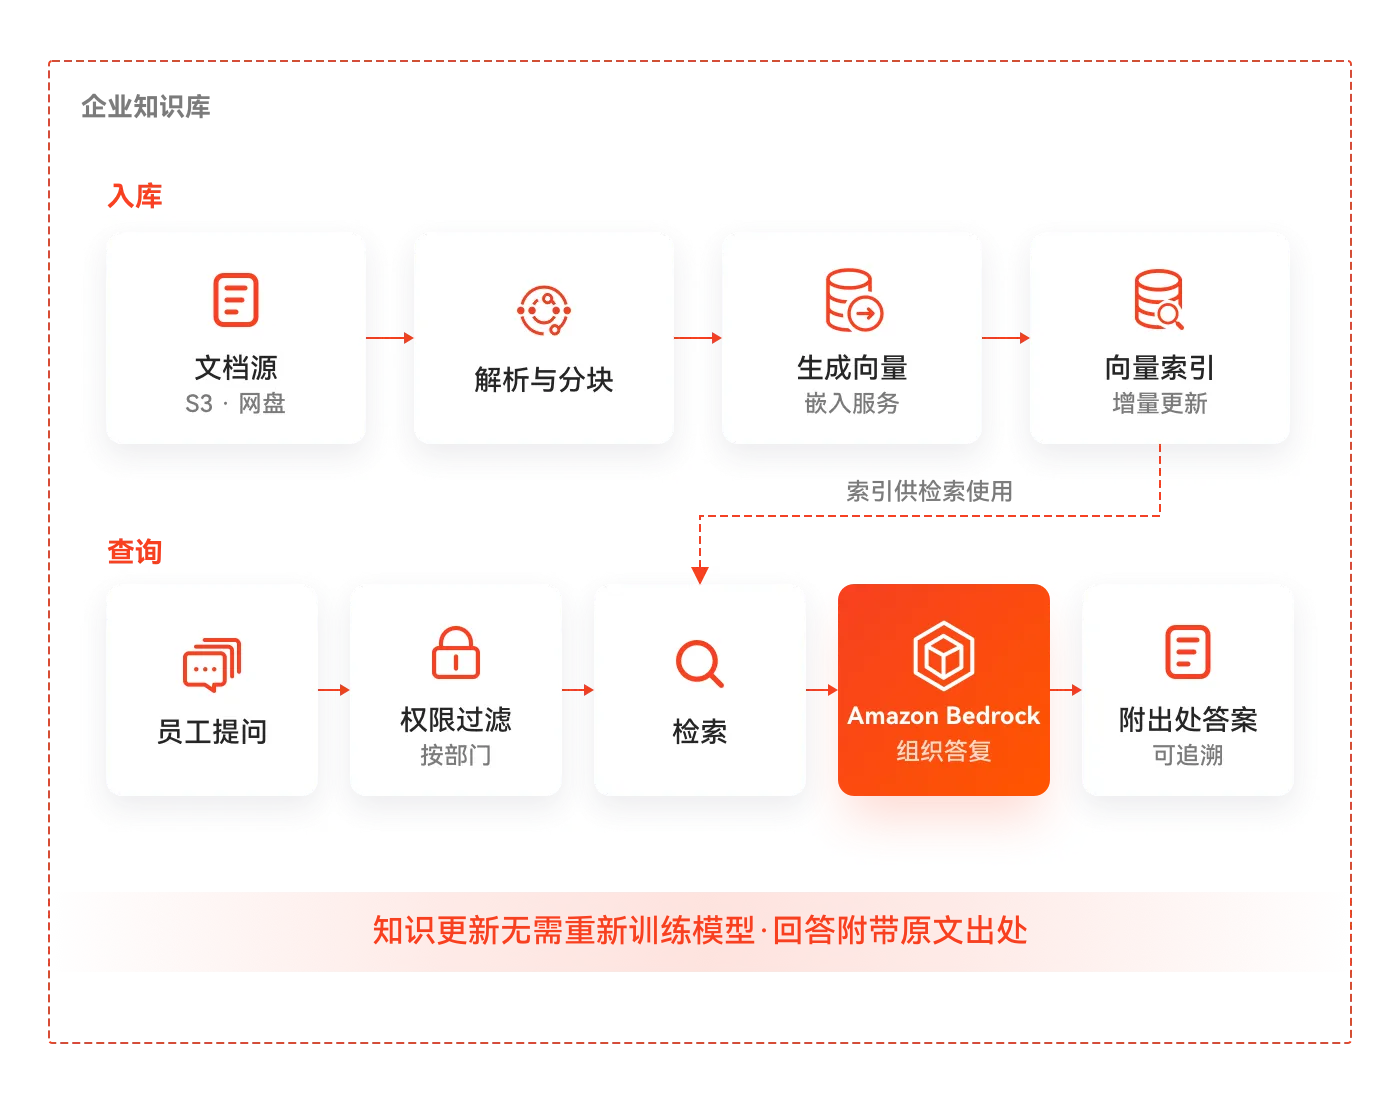
企业知识库
让员工以自然语言检索内部制度、产品文档与历史资料。文档持续入库并自动建立索引,回答附带出处,便于核对与追溯。
客户收益
按部门与权限控制可检索范围。
回答可追溯至原始文档,便于核对。
知识更新无需重新训练模型。
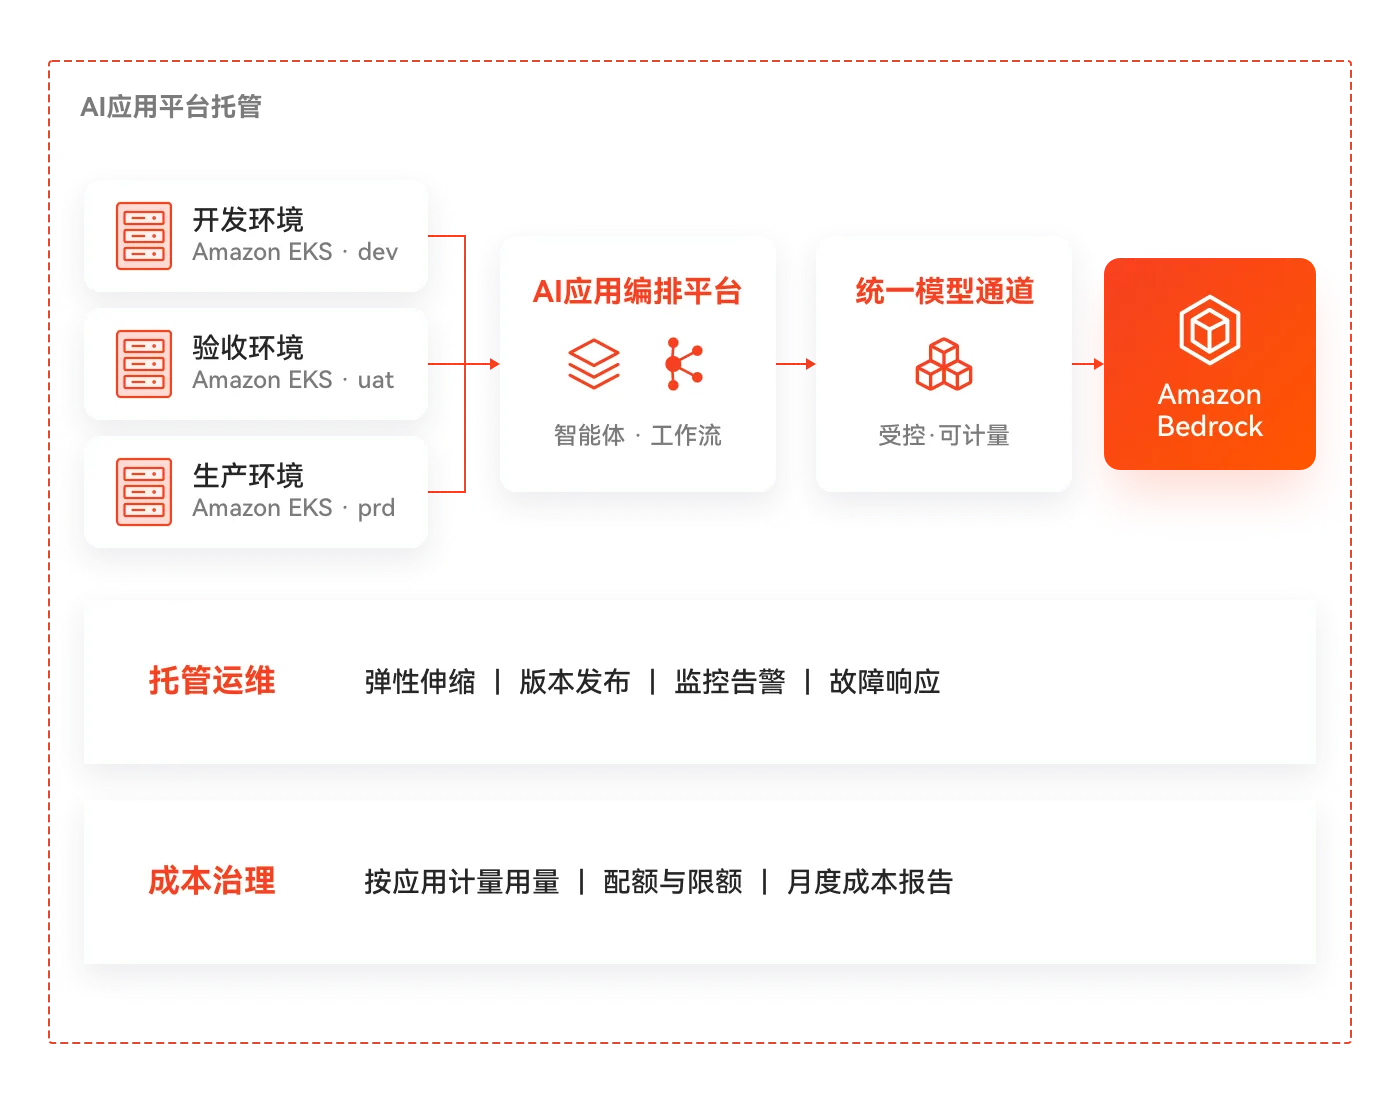
AI 应用平台托管
为 AI 应用编排平台与智能体提供稳定、隔离、可扩展的运行环境,并通过统一的受控通道连接模型服务。
客户收益
开发、验收、生产多环境隔离,发布可控。
容器化部署,按负载弹性伸缩。
模型访问统一管控,用量按应用计量。
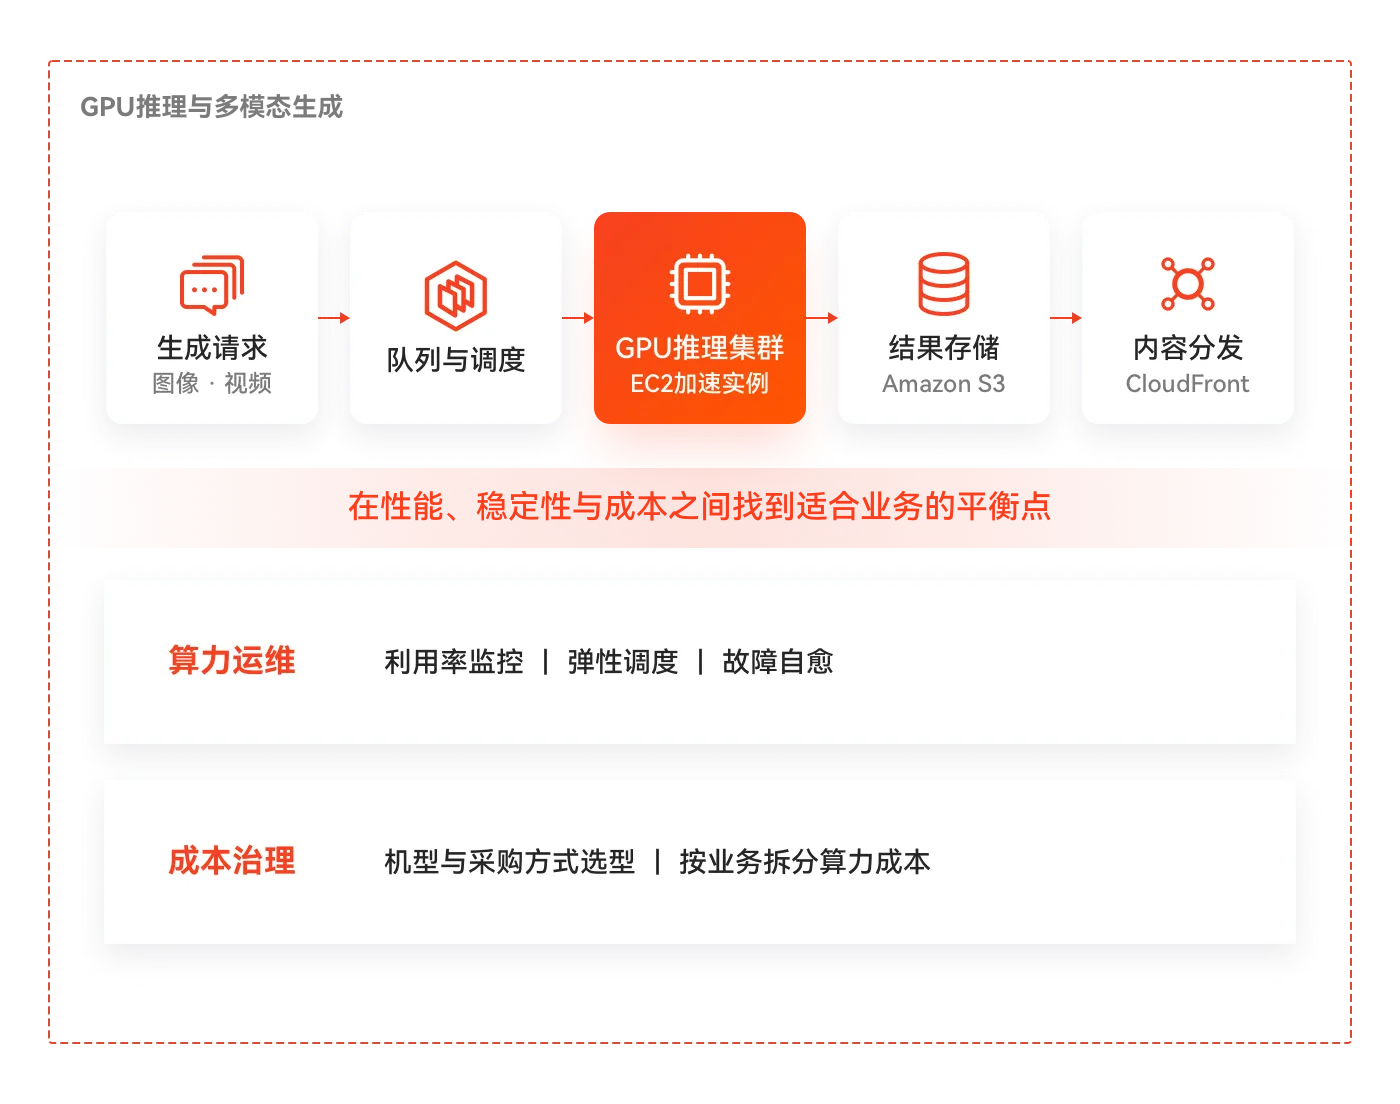
GPU 推理与多模态生成
为图像、视频等生成式负载规划与运维加速算力,在性能、稳定性与成本之间找到适合业务的平衡点。
客户收益
按负载特征选择机型与采购方式。
算力利用率持续监控与弹性调度。
按业务维度拆分算力成本。
方案架构
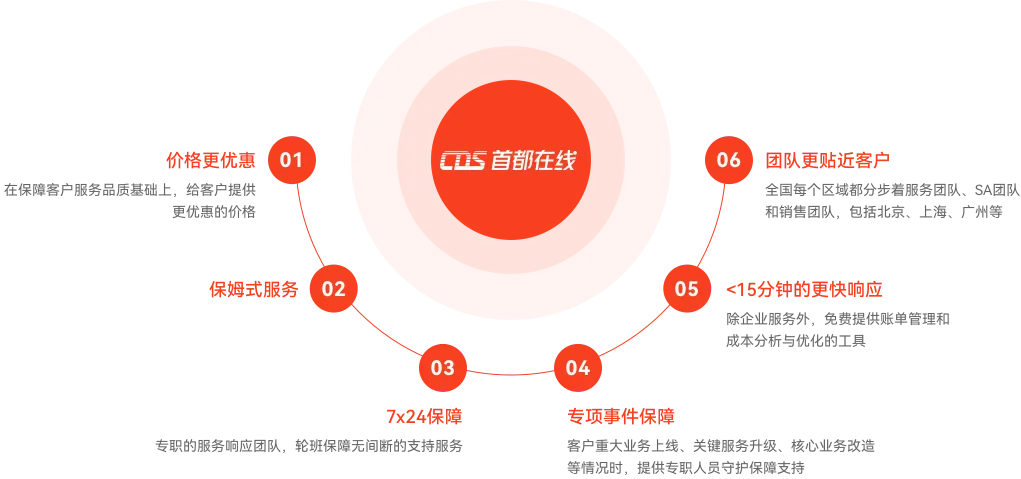
团队优势
快速响应能力
我们的资深工程师团队全天候 7×24 小时在线值守,能够以分钟级速度发现事件,且对重大问题的响应时间严格控制在 15 分钟以内,高效解决问题不拖延。
故障响应级别:
| 级别 | 影响范围 | 响应时间 |
|---|---|---|
| P0-紧急 | 核心业务完全不可用 | 15分钟 |
| P1-高 | 核心业务部分不可用 | 30分钟 |
| P2-中 | 非核心业务受影响 | 2小时 |
| P3-低 | 轻微影响或咨询 | 4小时 |
高效事件处理闭环
通过固定的运营会议,我们深入检视成本与安全性,并由资深工程师为您全面解析资源使用情况及安全状况,助力运营过程高效闭环。
强大的专业团队支持
我们引入多级资深人员支持体系,平均拥有 3 年以上行业经验的工程师全程深入了解您的业务背景,针对重点与难点项目提供全程跟进服务。
优质服务体验
每位托管的 MSP 客户均配备专属的固定运维工程师,在服务期间全面掌握您的 IT 环境状况,沟通对接灵活高效,建立紧密协作关系,提供卓越服务体验。


 关注首云